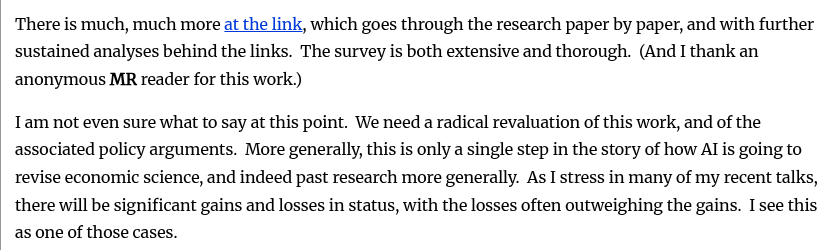
Tyler Cowen, 28 Ekim’de Marginal Revolution’da Emmanuel Saez ve Gabriel Zucman’ın araştırmaları hakkında bir yazı yayımladı. Dayanağı, kimliği açıklanmayan bir okuyucunun hazırladığı yapay zeka denetimiydi: 138 çalışma, 2.035 sorun, temel bir sayıyı değiştirecek ağırlıkta 147 bulgu. Cowen araştırmayı kapsamlı ve titiz buluyor; bu çalışmaların ve dayanak oluşturdukları politika önerilerinin köklü biçimde yeniden değerlendirilmesini istiyordu. Üstelik meseleyi araştırmacıların yaşayacağı itibar kaybına bağlıyordu. Yazı burada.
Bu kadar ağır bir hüküm için yapay zekanın ürettiği, yayıncı hataları ve spekülatif şüphelerle şişirilmiş bir hata sayısından fazlası gerekir. Hangi hata, hangi sonucu, ne ölçüde değiştiriyor? Bu değişikliklerden hangisi bir vergi önerisini geçersiz kılıyor? Cowen’ın yazısı bu soruları cevaplamadan hükmü veriyor. Bence asıl sorun burada: Çok okunan ve takip edilen Marginal Revolution, kanıtların taşıyabileceğinden daha büyük bir iddiaya dayanak yapılıyor.
Ben şahsen Saez ve Zucman’ın çalışmalarını ve daha adil bir vergi sistemi kurma çabalarını destekliyorum ve bu benim şahsi fikrim. Makalelerinin birçoğunu baştan sona okumuş, Oxford’daki derslerimde de kullanmış biriyim. Ancak bu destek, bütün bulgularını veya çalışmalarını savunacağım anlamına gelmiyor. Reinhart ve Rogoff da çok iyi iktisatçılar, ama yaptıkları Excel hatasının arkasında durmam mümkün değil. Dolayısıyla herkes gibi Saez ve Zucman da hata yapabilir. Ancak benim itirazım, önemli bir araştırma birikiminin hızlıca bir suçlama sayacına indirgenmesine. Bu sunumun bir itibar suikastına dönüştüğünü düşünüyorum. Tek tek bulguların neyi değiştirdiği ortaya konmadan, iki araştırmacının güvenilirliğine ve savundukları politikalara topluca hükmediliyor.
Kim yargılanıyor, ne tartışılıyor?#
Emmanuel Saez, gelir eşitsizliği, vergilendirme ve insanların vergi politikalarına tepkileri üzerine çalışan bir iktisatçı. Gabriel Zucman, vergi cennetlerinde tutulan servet, çokuluslu şirketlerin kâr aktarımı ve servet dağılımı araştırmalarıyla tanınıyor. İkisi de Amerikan Ekonomi Birliği’nin Clark Madalyası’nı aldı: Saez 2009’da, Zucman 2023’te. Ve bana kalırsa Nobel alacaklar. Elbette tüm bunlar kendilerini eleştiriden muaf kılmaz; bilakis tartışılan araştırma birikiminin ciddiyetini gösterir. AEA kaydı.
Kamuoyunda ise en çok zenginlerin daha fazla vergilendirilmesini savunmalarıyla biliniyorlar. Zucman’ın 2024’te G20 için hazırladığı öneri, milyarderlerin her yıl servetlerinin en az yüzde 2’si kadar bireysel vergi ödemesini amaçlıyor. İlgili gelir ve servet vergileri bu alt sınıra sayılıyor; şirket vergileri sayılmıyor. Kaliforniya’da 3 Kasım’da oylanacak Proposition 40 ise farklı: Belirli milyarderlerden bir defaya mahsus yüzde 5 servet vergisi alınmasını öngörüyor. Saez bu düzenlemenin hazırlanmasına katkı verdi. G20 raporu, resmî seçmen rehberi, tasarının hazırlanışı.
Dolayısıyla ortaya atılan iddialar, yalnızca akademik bir dipnot tartışmasına girmiyor. Çok büyük servetlerin nasıl vergilendirileceğine ilişkin somut bir siyasi mücadelenin ortasına düşüyor.
Rapordaki 2.035 sayısının içinde ne var?#
Denetim sitesindeki 138 raporun toplamı manşetle uyuşuyor. İçeriği ise daha fazla ayrım gerektiriyor:
| Sitenin sınıflandırması | Madde sayısı |
|---|---|
| Büyük sorun — major | 147 |
| Orta düzeyde sorun — moderate | 713 |
| Küçük sorun — minor | 1.175 |
| Toplam | 2.035 |
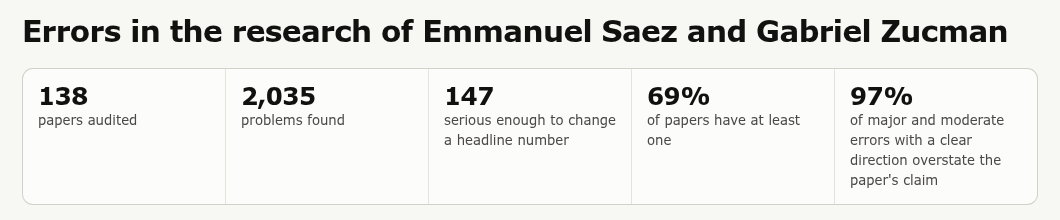
Bu etiketler denetimin kendi değerlendirmesi. Büyük sayılanların 61’i bile kendi güven ölçeğinde “doğrulanmış” düzeyine ulaşmıyor; “muhtemel” veya “akla yatkın” olarak işaretleniyor. Ayrıca 572 madde, daha önce bilinen sorun olarak tanımlanmış. Eski eleştirilerin derlenmesi yararlı olabilir; bunların hepsini yeni keşif sayamayız.
Çok paylaşılan “yüzde 97” de koşullu bir oran: Yönü belirlenen 722 büyük ve orta bulgunun 703’ünün, çalışmanın iddiasını olduğundan güçlü gösterdiği söyleniyor. Sitedeki 860 büyük ve orta bulgunun kalan 138’i bu hesaba girmiyor. Bu oran, araştırmaların yüzde 97’sinin yanlış olduğu anlamına gelmediği gibi, kasıtlı çarpıtmayı da kanıtlamıyor. Önce yön ve önem etiketlerinin doğruluğunu sınamak gerekiyor.
Küçük sorunların çokluğu, büyük bulguları kendiliğinden çürütmez. Tek bir ciddi hata bir makalenin sonucunu değiştirebilir. Ama yazım yanlışını, yöntem tartışmasını ve sonucu bozan hesap hatasını aynı toplamda biriktirmek, iki araştırmacının güvenilirliğini ölçen bir gösterge üretmez. Bu farkı görmek için birkaç maddeyi okumak yeterli.
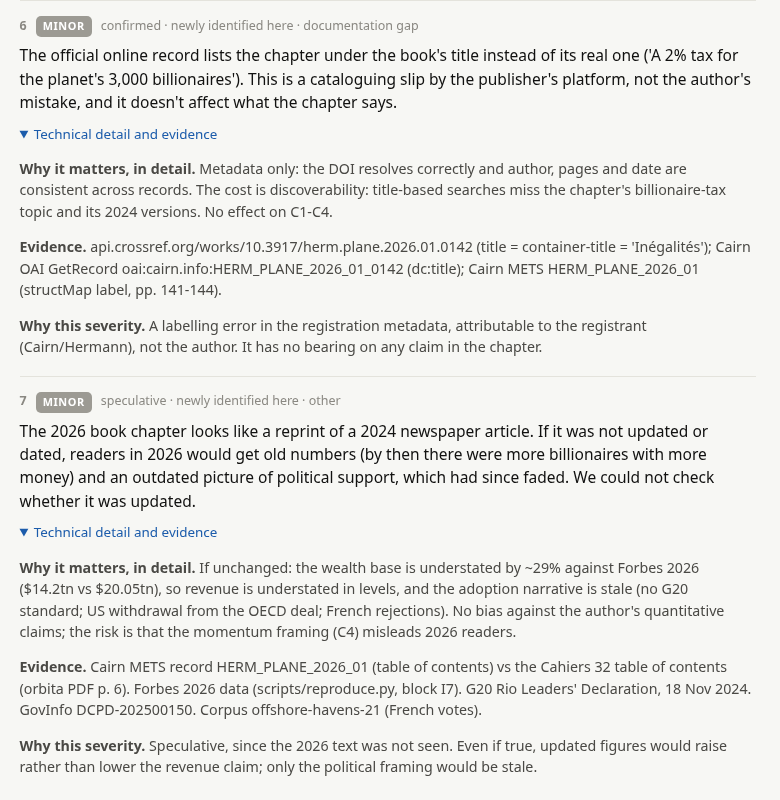
Zucman’ın Inégalités adlı derleme kitaptaki bölümü hakkında hazırlanan raporun altıncı maddesi, bölümün çevrimiçi kayıtta kendi başlığı yerine kitabın başlığıyla listelenmesini sorun sayıyor. Üstelik bunun yazarın değil, yayıncı platformunun hatası olduğunu ve bölümün iddialarını etkilemediğini bizzat rapor söylüyor. Buna rağmen madde, Saez ve Zucman’ın araştırmalarındaki sorunlar diye dolaşıma sokulan toplama ekleniyor. Altıncı madde, katalog kaydı.
Aynı raporun yedinci maddesi daha çarpıcı. Bölümün eski bir yazıyı güncellemeden yeniden yayımlamış olabileceğini söylüyor. Fakat 2026 tarihli metni görmediğini de kabul ediyor. Olasılığın doğruluğu bilinmiyor; yine de “bulunan sorunlar” arasına giriyor. Burada uydurulmuş bir alıntı yakalamış değiliz. Daha basit bir problem var: Okunmamış bir metin hakkındaki şüphe, manşette bulgu sayılıyor. Açıklamadaki ihtiyat, toplamın kesinliğinde kayboluyor.
Bir başka örnek, Saez’in ortak yazarı olduğu 2014 tarihli kuşaklar arası gelir hareketliliği çalışması. Denetimin ilk büyük bulgusunun özeti, 1982’den sonra doğanların yetişkinlik gelirlerinin henüz gözlenemediğini söylüyor. Oysa makale, 1986 doğumlulara kadar 26 yaşındaki geliri gözlüyor. Gözlenemeyen, 1982’den sonra doğanların 30 yaşındaki geliriydi. Denetimin ayrıntılı açıklaması da bu ayrımı içeriyor. Okurun ilk karşılaştığı özet ise onu siliyor. Denetim, özgün makale, s.143–145.
Makalenin sonraki kuşaklara ilişkin tahmini varsayımlara dayanıyor; bu varsayımların değişmesi sonucu etkileyebilir. Bu eleştiri incelenmeli. Fakat eleştirenin de verinin neyi gözlediğini doğru anlatması gerekir. “Büyük hata” etiketi, yanlış bir özeti doğru yapmaz.
Coğrafi hareketlilik makalesinde de yerler arasındaki farkın büyüklüğü tartışılıyor. Her bölgeye eşit ağırlık verilmesiyle, bölgelerin nüfuslarına göre ağırlıklandırılması farklı sonuçlar üretiyor. Denetim, aile gelirine kıyasla yaklaşık yüzde 60 diye sunulan büyüklüğün nüfus ağırlığıyla yaklaşık yüzde 35’e indiğini belirtiyor. Fakat her iki hesabın dayandığı standart sapmalar özgün makalede birlikte verilmiş. Tipik bir çocuğun deneyimini hangisinin daha iyi anlattığı tartışılabilir; burada açığa çıkarılan gizli bir hesap hatasından söz edemeyiz. Denetim, üçüncü madde, makale, s.1592–1593.
Bu örnekler bütün büyük bulguların yanlış olduğunu göstermiyor. Hataların kime atfedildiği, nasıl sınıflandırıldığı ve kamuoyuna nasıl aktarıldığı konusunda somut sorunlar gösteriyor. Cowen’ın verdiği hüküm tam da bu nedenle erken.
Ciddi bulguları ciddiye almak#
Birleşik Krallık için Ben Tippet ve Zucman’ın hazırladığı minimum vergi raporundaki bir eleştiri önemsenmeli. Rapor, 100 milyon sterlinin üzerinde serveti olan hanelerin mevcut bireysel gelir vergisini servetlerinin yüzde 0,2’si kabul ediyor. Atıf yaptığı G20 çalışması ise milyarderler için yüzde 0,3, serveti 100 milyon–1 milyar dolar arasında olan bireyler için yüzde 1,2 kullanıyor. Bu alternatif oranlar, Birleşik Krallık raporunun servet toplamlarına uygulandığında gelir tahmini yaklaşık 10,4 milyar sterlinden 8 milyara iniyor: yüzde 23 azalma. Birleşik Krallık raporu, G20 kaynağı, denetim.
Hesapta raporun vergi kaybı için ayırdığı yüzde 10’luk pay korunuyor. Bu, önemsiz bir yazım hatası değil. Ülke, eşik ve grup tanımları farklı olduğundan 8 milyar sterlini doğrulanmış tahsilat tahmini sayamayız; fakat varsayımın sonucu ne kadar değiştirdiğini görebiliriz. Artan oranlı vergilendirmeyi savunmak, her gelir tahminini savunmayı gerektirmez. Bir tahminin aşağı çekilmesi de milyarderlerin vergilendirilmesine ilişkin bütün gerekçeleri ortadan kaldırmaz.
Saez ve Zucman zaten 2020’de bazı eleştirileri haklı bulup hesaplarını yenilemişti. Birleşik düzeltmeler, 1978–2014 arasında en üst yüzde 1’in vergi öncesi gelir payındaki tahmini artışı 9,4 puandan 8,5 puana indirdi. Araştırma böyle ilerler: Hangi tahminin neden değiştiğini göstererek. Eski sürüm, düzeltilmiş sürüm ve süren yöntem tartışması arasındaki ayrımı koruyarak. 2020 çalışması, s.2–3.
Bu itibar suikastının sorumlusu kim?#
Denetimde iki yapay zeka modeli ve bunların bulgularını değerlendiren üçüncü bir ajan kullanılmış. Raporlarda reddedilen iddialar ve sınırlılıklar da var. Dolayısıyla bunu tek bir gelişigüzel komuttan ibaret saymak doğru olmaz. Ancak incelenen sayfalarda kullanılan komutlara, işlem kayıtlarına veya indirilebilir denetim kodlarına bağlantı yok. Kamuya açıklanan yöntemde bulguların sorumluluğunu üstlenen, adı belli bir insan denetçi de görünmüyor.
Tepkiler bu nedenle Saez ve Zucman taraftarlarıyla sınırlı kalmadı. Sylvain Catherine, onlara karşı olumsuz önkabullerine rağmen bu değerlendirmenin fazla ciddiye alınmaması gerektiğini yazdı. Mike Konczal, açıklanmış yöntem tercihlerinin büyük sorun diye sunulmasına itiraz etti. Buna karşılık Phil Magness, önemli eleştirilerin zaten insan araştırmacılar tarafından yapıldığını vurguladı. Bu da doğru soruya götürüyor: Hangi eleştiri, hangi kanıtla ayakta kalıyor?
Jason Furman yapay zekaya bir karşı inceleme yaptırdı; bunun hiçbir şeyi kanıtlamadığını da açıkça söyledi. Bu uyarı değerli. Yapay zekanın bir tarafı suçlaması nasıl yeterli değilse, başka bir çıktının onu aklaması da yeterli değil. Birbirinden ayrı çalışan modellerin aynı hükme varması, bağımsız uzman doğrulamasının yerine geçmez.
Elbette yanlış bir hesabı düzeltmek için bütün iktisatçıları taramak gerekmez. Fakat iki araştırmacıyı olağanüstü güvenilmez ilan etmek için bir karşılaştırma ölçüsü gerekir. Aynı işlem başka çalışmalar üzerinde ne üretiyor? Küçük tercihler birlikte büyük etki yapıyorsa, o etki hesaplanmalıdır. Madde sayısı bunun cevabı değildir.
Elon Musk’ın alkışı#
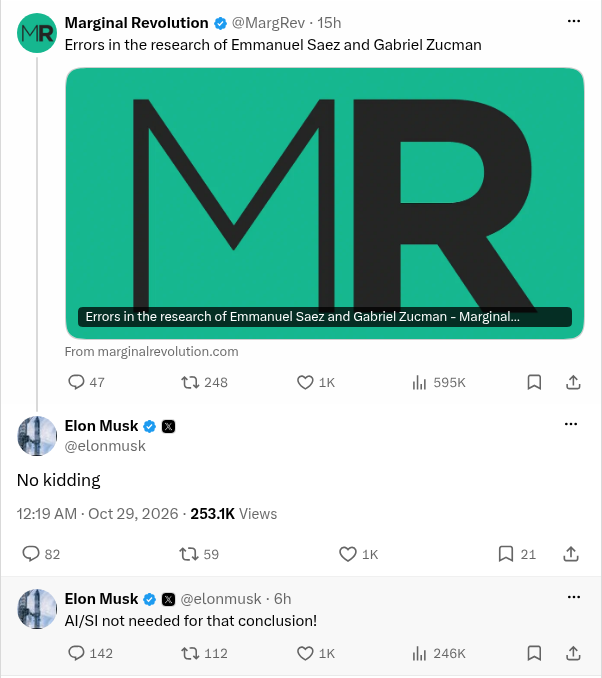
Musk’ın tepkisi de bu tartışmanın siyasi karşılığını gösteriyor. Marginal Revolution’ın paylaşımına önce “No kidding”, ardından “AI/SI not needed for that conclusion!” diye yanıt verdi: Bu sonuca ulaşmak için yapay zekaya bile gerek olmadığını söylüyordu. Milyarderlerin vergilendirilmesini savunan iki araştırmacıya yönelen toplu suçlamayı, bir milyarder açıkça alkışladı. İlk yanıt, ikinci yanıt.
Cowen’ın yazısı Kaliforniya’daki oylamadan altı gün önce yayımlandı. Bu zamanlama ve Musk’ın desteği, yapılan sunumun kimler tarafından sevinçle karşılandığını gösterir. Musk’ın denetimi yaptırdığını veya finanse ettiğini kanıtlamaz. Bunun için gizli bir plan icat etmeye de ihtiyaç yok: Teknik iddiaların, henüz ağırlıkları belirlenmeden, vergi savunucularının itibarını aşındıran bir mesaja dönüşmesini gözümüzün önünde izliyoruz.
29 Ekim tarihli ekran görüntüsünü göster
Cowen’ın üstlenmesi gereken iş açık. En güçlü bulguları seçmeli, hesapların yeniden yapılabilmesini sağlamalı, yetkin insanların değerlendirmesini ortaya koymalı ve hangi politika sonucunun neden değiştiğini açıklamalı. Yanlış özetleri de düzeltmeli. Bir internet sitesini duyurmanın kolaylığı, verilen hükmün sorumluluğunu azaltmıyor. Saez ve Zucman’dan talep edilen bilimsel özen, onları mahkûm edenlerden de talep edilmeli.